Transformer详解
背景
观前思考:为什么 Transformer 能在短短几年内,彻底取代 RNN 和 LSTM,成为 NLP 乃至整个 AI 领域的基石?
在Transformer之前,NLP领域广泛使用RNN或LSTM进行序列建模和文本生成。RNN和LSTM都是循环结构,它们维护一个不断更新的隐藏状态,将历史信息压缩其中,并根据这个状态和当前输入来预测下一个词。但这样的结构带来了两个突出的问题。
首先是训练速度问题。由于RNN和LSTM必须按时间步依次计算:算完 才能算 。整个序列是高度串行化的,无法像矩阵运算那样充分并行。这使得它们很难利用现代GPU大规模并行的优势,训练速度受到严重制约。
其次是长距离依赖问题。在自然文本中,相距很远的词句之间也可能存在语义关联。然而RNN的信息必须沿时间步逐步传递,在处理长序列时极易出现梯度消失或梯度爆炸。LSTM通过门控机制大幅缓解了这一问题,但信息仍须逐步传递,在足够长的序列上依然会出现衰减,难以真正捕捉远距离的依赖关系。
以上两个问题,前者意味着RNN和LSTM训练慢,后者意味着它们甚至很难训练好。在这种背景下,2017年,Vaswani等人提出了Transformer(“Attention Is All You Need”)。它彻底抛弃了循环结构,转而使用自注意力机制:所有位置的Query、Key、Value可以同时计算,整个序列一把送入模型做矩阵运算,天然适合大规模并行。这正是如今成千上万张GPU组成的算力集群得以发挥作用的前提。与此同时,自注意力让文本中任意两个位置都能直接交互信息,路径长度仅为O(1),从根本上改变了长距离依赖的传递方式。
当然,去掉循环结构也意味着模型不再天然感知词序,因此Transformer需要额外引入位置编码来告诉模型谁在前、谁在后。此外,自注意力的计算复杂度随序列长度呈O(n²)增长,这在超长序列场景下会带来新的瓶颈,也催生了后来FlashAttention、线性注意力等一系列优化工作。
尽管如此,Transformer在并行训练和长距离依赖建模方面展现出显著优势,并迅速成为NLP领域的主流架构。后来的GPT系列取其decoder部分做自回归生成,BERT取其encoder部分做双向理解,而当下的大语言模型,几乎都是在这一架构基础上演化而来的。
Transformer 发展与演变
原始论文里的Transformer是Encoder-Decoder结构。此后,围绕不同任务需求逐渐形成了三类主要架构范式:Encoder-only、Encoder-Decoder以及Decoder-only,代表模型分别包括BERT、T5和GPT。如今,在通用大语言模型领域,Decoder-only已经成为最主流的架构范式之一。
ps. 突发情况,由于2026.9.10 DeepSeek 发布的最新模型 DeepSeek V4.1 flash中重新采用了 Encoder-Decoder架构,所以本篇文章所述的“Decoder-only已经成为最主流的架构范式之一”可能在之后有些许改变。但这句话倒也没错,因为实际上 v4.1f 的所谓 “Encoder-Decoder” 架构也还是Decoder-only 架构的一种改进。在未来我会出一篇Blog来详细讲解这个改进版的"Decoder-only"架构。
下面我们来深入了解一下原始Transformer以及三种变体。
原始 Transformer
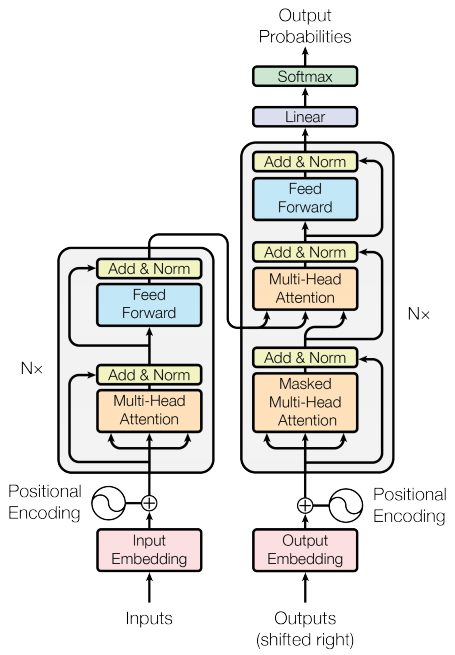
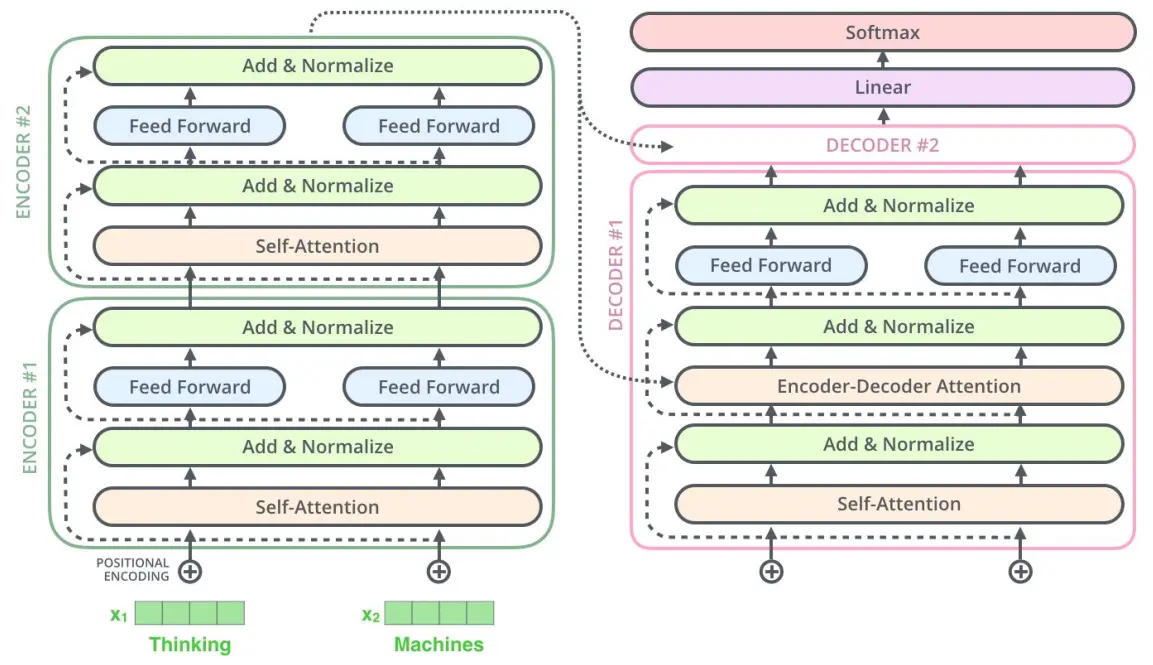
如图1所示,原始Transformer是由若干个Encoder和若干个Decoder组成。其中包含三种Attention,分别是 Multi-Head Self Attention,Masked Multi-Head Self Attention,以及 Cross Attention。
Encoder
Encoder由两个核心子层组成,分别是Multi-Head Self-Attention以及Feed-Forward Network(FFN)。它接收token序列的表示,输出与原序列维度一致的表示序列,该序列随后会被送入下一层Encoder,或在最顶层作为Decoder中Cross-Attention的Key和Value来源。
原始Transformer将N=6个结构相同的Encoder层依次堆叠。每一层的输入和输出维度都是 ,这一设计使得层与层之间可以无缝衔接,也方便通过增加层数来扩展模型容量。
子层结构:残差连接 + 层归一化
每个子层并非单独存在,而是被包裹在一个统一的模式(此处介绍Post-Norm,后文再介绍Pre-Norm)中:
其中 是Self-Attention或FFN的输出。这里有两个关键部分:
- 残差连接(Residual Connection):将输入 直接加到子层输出上。这使得梯度可以绕过子层直接回传,有效缓解了深层网络中的梯度消失问题,也让6层乃至更多层的堆叠成为可能。
- 层归一化(Layer Normalization):对每个样本在特征维度上做归一化,使训练过程更加稳定。
Self-Attention子层
在Encoder中,Self-Attention是无掩码(unmasked) 的,也就是说,序列中的每个位置都可以同时关注所有其他位置。这使得Encoder天然具有双向建模的能力,每个token的表示都融合了来自整个上下文的信息。
具体而言,输入序列中的每个token通过三组不同的线性变换,分别生成Query()、Key()和Value()向量。注意力的计算公式为:
其中 是一个缩放因子,用于防止点积值过大导致softmax梯度趋近于零。
而Multi-Head机制则是将 、、 分别拆分为 个头,每个头独立地执行上述注意力计算,最后将所有头的输出拼接起来,再通过一个线性变换映射回 维度:
多头的意义在于,不同的头可以学到不同的关注模式。有的头可能关注语法结构,有的关注语义相似性,有的关注位置邻近关系,从而让模型获得更丰富的表示能力。
Feed-Forward Network(FFN)子层
经过Self-Attention之后,每个位置的表示已经融合了全局信息。接下来,FFN对每个位置独立地做非线性变换:
这是一个两层的全连接网络,先将维度从 扩展到 (通常是4倍),经过ReLU激活后,再压缩回 。FFN的作用可以理解为对注意力层聚合后的信息做进一步的非线性加工,为模型引入更强的表达能力。
小结:一层Encoder的完整流程
将上述组件串起来,一层Encoder的完整流程是:
6层这样的结构依次堆叠,最终输出的表示序列既保留了每个位置自身的语义,又充分融合了全局上下文信息。这个输出将作为Decoder中Cross-Attention的Key和Value,供Decoder在生成时查阅源端信息。
Decoder
该部分由三个核心子层组成,分别是 Masked Multi-Head Self-Attention、Cross Attention 以及 Feed-Forward Network(FFN)。相比Encoder,Decoder多了一个Cross Attention子层,用于从Encoder表示中选择性地读取源序列信息。同样地,原始Transformer将 N=6 个Decoder层依次堆叠,每层的输入输出维度均为 =512。
在推理(生成)阶段,Decoder的工作方式是自回归的:它接收已经生成的目标序列 ,经过三个子层处理后,输出下一个位置的概率分布,采样得到 ,再拼接到输入序列中,循环往复,直到生成结束符。而在训练阶段,目标序列会通过Teacher Forcing一次性全部输入,模型并行地学习每个位置的预测,无需逐步生成。
与Encoder相同,Decoder中每个子层也都包裹着残差连接和层归一化:
因果掩码自注意力(Masked Multi-Head Self-Attention)
在生成任务中,位置 的token只能看到自己和之前的信息,不能偷看未来的内容。为此,我们需要对Self-Attention施加因果掩码(Causal Mask)。
具体做法是:构造一个矩阵,其下三角(含对角线)为0,上三角为 ,然后将其加到注意力分数上:
其中 = (当 ), = (当 )。这样,经过softmax后,未来位置的注意力权重趋近于零,模型自然无法获取尚未生成的信息。
直观来看,下三角为1表示可见,上三角为0表示被遮蔽:
Cross Attention(交叉注意力)
经过因果掩码自注意力并完成残差连接和层归一化后,其输出通过线性变换生成Cross Attention的 Query,代表"目标序列当前需要什么信息"。而Encoder最顶层的输出则同时作为 Key 和 Value,代表"源端序列能提供什么信息"。二者进行标准的注意力计算:
其中 来自Decoder, , 来自Encoder。这一机制让Decoder在每一步生成时都能回望整个源句,选择性地提取与当前生成最相关的信息。计算完成后,同样经过残差连接和层归一化,送入下一个子层。
Feed-Forward Network(FFN)
与Encoder中的FFN结构完全相同:
先将 扩展到 ,经ReLU激活后再压缩回512。它对每个位置独立地进行非线性变换,相当于对注意力层聚合后的信息做进一步的深加工,增强模型的表达能力。
小结:一层Decoder的完整流程
6层这样的结构堆叠后,最顶层的输出经过一个线性层+softmax,得到词表上的概率分布,从而完成下一个token的预测。
三种变体
随着NLP任务需求的多样化,原始Transformer的Encoder-Decoder结构逐渐演化出三个主要流派。它们分别针对理解、序列到序列和生成任务进行了特化。
Encoder-only(专注于理解)
该变体的代表是谷歌在2018年发布的 BERT模型。相比于原始Transformer,该变体删去了Decoder部分,仅保留Encoder部分。
由于没有因果掩码的限制,Encoder-only模型在计算Self-Attention时,每个token都能同时关注到序列中所有的其他token(即双向注意力)。这种全局视野使其在自然语言理解任务上表现出极强的优势。
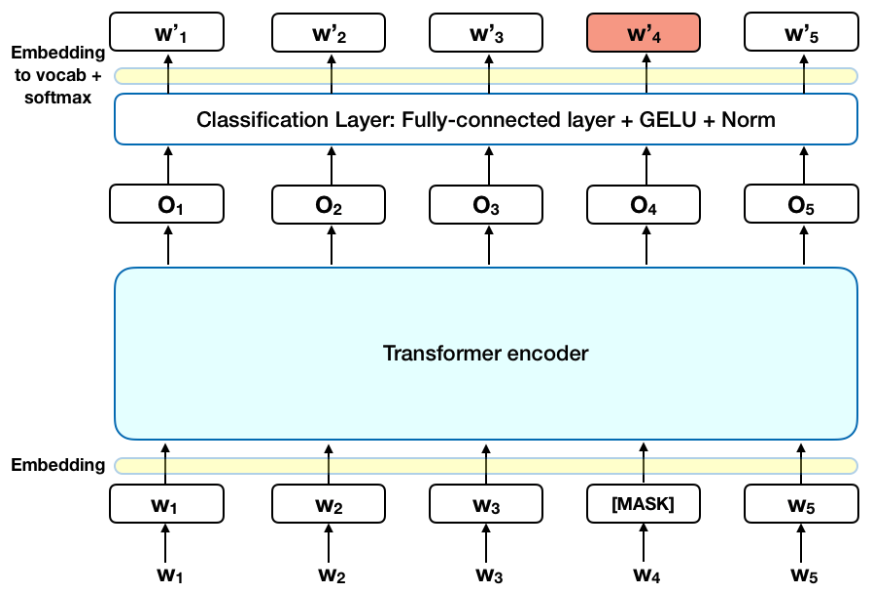
在预训练阶段,BERT主要采用掩码语言建模(Masked Language Modeling, MLM),即随机遮住输入序列中的一些token(如[MASK]),让模型根据上下文来预测这些被遮住的词。这种训练方式赋予了模型深厚的语义表征能力。预训练完成后,只需在顶层添加一个简单的线性层进行微调(Fine-tuning),就能很好地应用于文本分类、情感分析、命名实体识别(信息抽取)和句子相似度等下游任务。
Encoder-Decoder(范式统一与序列到序列)
该变体保留了原始Transformer的完整结构,代表模型包括谷歌在2019年发布的 T5模型 以及早期的BART等。
T5模型做了一件极具影响力的事情:将所有NLP任务都转化为“Text-to-Text”(文本到文本)的格式。这意味着,无论是翻译、文本摘要、问答,还是传统的文本分类任务,模型的输入都是一段文本提示(Prompt),输出也是一段文本。
例如,做情感分类时,输入不再是单纯的句子,而是 classify: This movie is great,输出则是 positive。
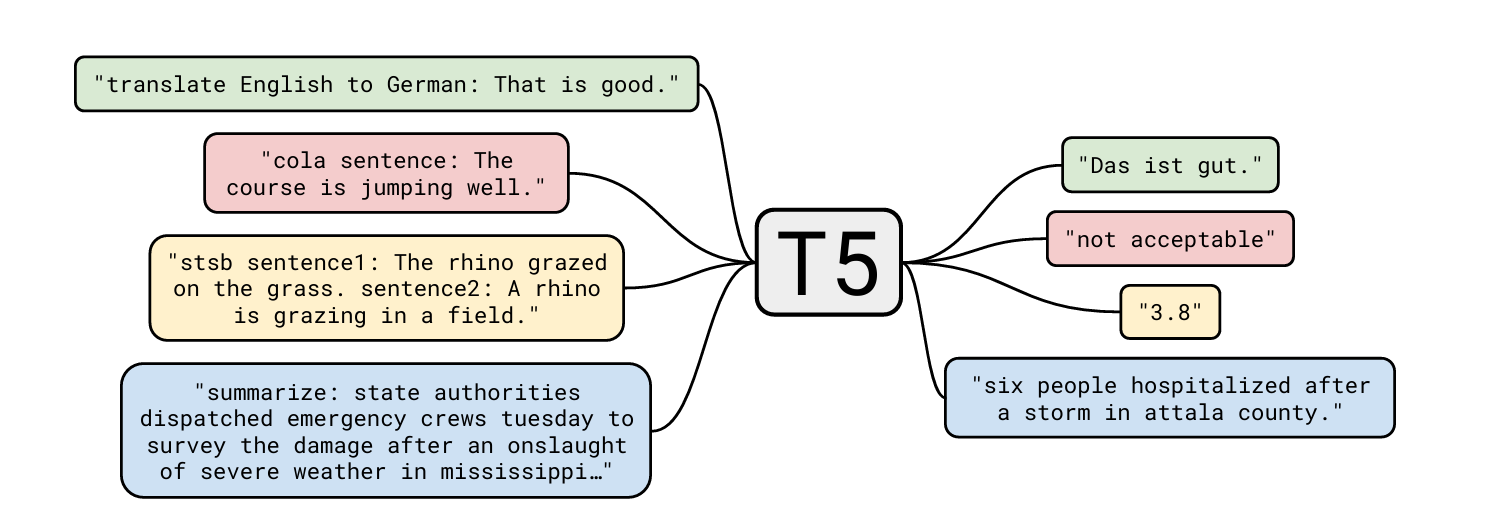
这种架构的优势在于:Encoder负责双向地编码源文本,Decoder负责自回归地生成目标文本。通过统一的Text-to-Text框架,大量不同任务都可以转化为序列到序列问题,从而复用相同的训练范式和模型结构。
Decoder-only(生成式大模型的绝对主流)
简单介绍
该变体最出名的代表是 OpenAI 的 GPT 系列(Generative Pre-trained Transformer)。它的成功彻底改变了当今 AI 的发展轨迹。
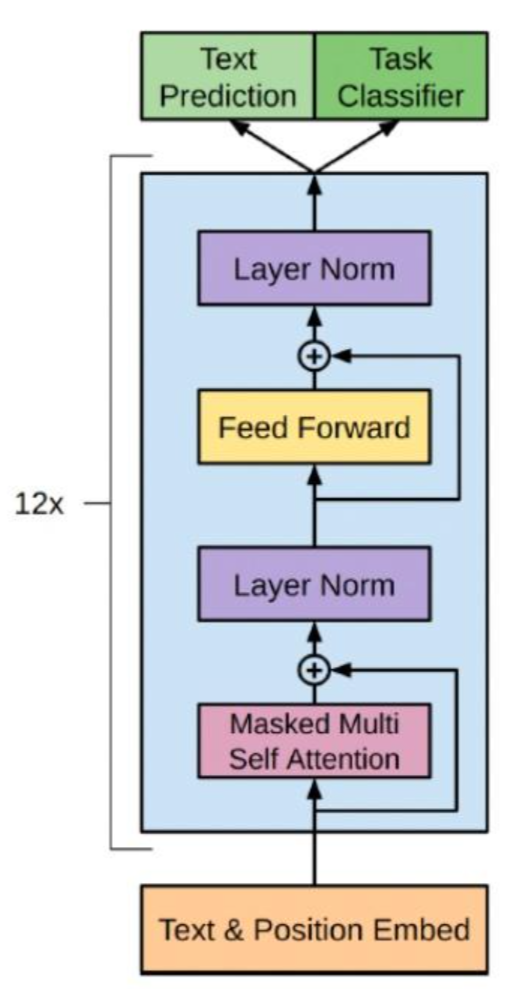
从结构上看,该架构大刀阔斧地去掉了 Encoder 和 Cross-Attention,仅保留了带有因果掩码的 Masked Self-Attention 和 FFN。它的工作原理非常纯粹:输入一段 token 序列,模型只能看到前面的词,然后自回归地预测下一个 token。
为什么看似残缺、且只能单向注意力的架构,最终在通用大语言模型领域占据主流?核心原因可以从以下几个方面理解:
- 统一的生成范式与 Scaling Law(缩放定律):Decoder-only 天然契合自回归的语言生成过程。研究发现,随着模型参数量、数据量和计算量的增加,Decoder-only 模型的性能会呈现出可预测的幂律增长。这使得工业界可以坚定地将算力投入到扩大模型规模上,从而力大砖飞。
- 涌现能力(Emergent Abilities)与上下文学习:当模型规模突破一定阈值后,它展现出了惊人的能力,即无需更新参数,只需在输入中提供几个示例(Few-shot Prompting),模型就能理解并执行全新的任务。这种以生成式语言建模为核心的上下文学习范式,与Decoder-only的训练目标和推理方式尤其契合。
- 极佳的预训练并行性:虽然生成(推理)阶段是串行的,但在海量的预训练阶段,由于整个长文本序列可以同时输入,并利用因果掩码进行高度并行的矩阵运算,这使得在成千上万张 GPU 集群上训练巨量参数的模型成为可能。
- 交互方式的天然契合:人类的自然交流方式本质上就是对话和文本生成。Decoder-only 架构天然适合构建像 ChatGPT 这样的对话式智能体。
简而言之,Decoder-only架构以相对简单的结构,将大量语言任务统一到自回归序列建模与生成框架中,并凭借良好的规模化训练特性成为当前通用大语言模型的主流范式。
下面来深入了解Decoder-only模型
1. 端到端数据流:一次推理的完整旅程
Decoder-only 架构将模型简化为一条极其纯粹的单向数据流。以一次实际的 LLM 推理为例,我们可以跟踪数据从输入到输出的完整生命周期:
假设用户输入:“ABCDEFG”
-
Step 1: 分词与嵌入 (Tokenization & Embedding)
文本首先经过 Tokenizer 转化为 Token ID 序列(如[1234, 567, 89, 2345, 678])。随后,通过查表操作(Token Embedding),将这些离散的 ID 映射为连续的稠密向量,得到形状为 的输入矩阵 。 -
Step 2: 穿越 Decoder Block 堆叠
矩阵 依次穿过 层结构完全相同的 Decoder Block。在每一层中,数据会经历:
RMSNorm -> Masked Self-Attention (含 RoPE 位置编码) -> 残差连接 -> RMSNorm -> FFN (如 SwiGLU) -> 残差连接。
经过 层处理后,输出矩阵 的维度依然严格保持为(seq_len, d_model)。ps. 此处LayerNorm放在最前的做法是PreNorm的方法。
即 -
Step 3: 输出映射 (LM Head)
经过最后一次 RMSNorm 归一化后,送入语言模型头(LM Head)。这是一个线性层,将 维的隐藏状态映射回词表大小 ,得到 Logits 矩阵 。 -
Step 4: 概率计算与采样
我们只提取 Logits 矩阵中最后一个时间步(即最后一个 token 的位置)的向量,通过 Softmax 函数将其转化为词表上的概率分布。接着,根据设定的采样策略(如 Greedy、Top-p、Temperature 等)从概率分布中采样出下一个 Token。 -
Step 5: 自回归循环
将新生成的 Token 拼接到原输入序列的末尾,重新送入模型,重复上述过程,直到生成结束符(EOS)或达到最大长度限制。
整个前向传播与自回归生成的数学表达可以极其简洁地概括为:
2. 架构演进:与原始 Transformer 的核心差异
将现代 Decoder-only 架构与原始的 Encoder-Decoder Transformer 并排对比,可以清晰地看到前者在工程实现和理论设计上做了哪些减法与进化:
| 对比维度 | 原始 Transformer | 现代 Decoder-only | 演进意义 |
|---|---|---|---|
| 整体结构 | 包含 Encoder 和 Decoder 两部分 | 仅保留 Decoder 部分 | 极致简化,统一为自回归生成范式 |
| 注意力机制 | Encoder: 双向注意力 Decoder: 因果掩码注意力 |
仅有因果掩码的 Self-Attention | 舍弃双向理解,专注自回归预测 |
| Cross-Attention | Decoder 每层都有,用于融合 Encoder 信息 | 无 | 无需外部条件输入,实现端到端统一 |
| 位置编码 | 加法注入 | 旋转注入(RoPE 相对位置编码) | RoPE 提供了自然的相对位置信息,但超出训练长度时仍可能出现性能退化 |
| 归一化位置 | Post-Norm(残差连接后归一化) | Pre-Norm(残差连接前归一化) | Pre-Norm 训练更稳定,允许堆叠更深的层数 |
| 归一化方式 | LayerNorm(计算均值和方差) | RMSNorm(仅计算均方根) | 减少计算开销,且在大模型中效果相当甚至更好 |
| FFN 激活函数 | ReLU | SwiGLU 或 GeGLU | 引入门控机制,显著提升模型表达能力 |
| 输出头权重 | 独立的 Linear 层 | Linear 层(部分模型会采用 Weight Tying,但并非普遍如此) | 减少参数量,增强输入输出空间的语义一致性 |
通过上述对比可以看出,现代Decoder-only并非只是简单地砍掉Encoder,而是伴随大模型时代的计算与训练需求,在归一化、位置编码、激活函数、注意力头设计等底层细节上进行了持续演进。
Transformer 组件详解
在宏观了解了 Transformer 的架构演变后,我们需要深入其内部,拆解构成大模型的原子级组件。无论是 2017 年的原始 Transformer,还是当今如日中天的 GPT 系列,其核心都由几个关键模块拼装而成。以下来深入解析这些组
1. Attention (注意力机制)
基本原理
注意力机制是 Transformer 的灵魂。它打破了 RNN 的时间步限制,让序列中的每个词都能直接看到并关注其他相关的词。
输入向量通过三个不同的线性变换矩阵,映射为 Query(查询)、Key(键)和 Value(值):
- Query (Q):代表"我正在寻找什么信息"。
- Key (K):代表"我有什么特征,可以被别人检索到"。
- Value (V):代表"我实际包含的具体内容"。
核心公式为缩放点积注意力(Scaled Dot-Product Attention):
其中 计算了 Query 和 Key 的相似度(内积)。除以 是至关重要的一步:当维度 较大时,点积结果的方差会很大,导致 softmax 函数进入梯度极小的饱和区(输出趋近于 one-hot 分布),使得梯度消失无法反向传播。缩放因子有效缓解了这一问题。
多头注意力(Multi-Head Attention, MHA) 将 Q、K、V 拆分成 个头,每个头在独立的子空间中进行注意力计算,最后将结果拼接并做线性映射:
这使得模型能够同时关注来自不同位置、不同语义子空间的信息。
参数量分析(原始 MHA)
以 ,, 为例:
| 权重矩阵 | 形状 | 参数量 |
|---|---|---|
| 合计 | 67.1M |
现代做法:GQA / MQA / Flash Attention
(1)KV Cache 瓶颈问题
在 LLM 推理的自回归 Decode 阶段,为了避免每生成一个token都重新计算历史token的 Key 和 Value,需要把已经计算过的 Key 和 Value 缓存下来(即 KV Cache)。
对于标准 MHA,KV Cache 的显存占用为:
其中 是层数, 是K/V头数, 是每头维度, 是序列长度, 是batch size,前面的 代表K和V两份, 表示每个元素占用的字节数。例如FP16/BF16通常为2字节。对于标准MHA,有 。
以 LLaMA-2-70B 为例(),当序列长度 ,batch size 时:
这仅仅是一个请求的 KV Cache而已。在长上下文(128K tokens或者更长)场景下,这个数字会膨胀到不可接受的程度。
(2)GQA(Grouped-Query Attention)
核心思想是,让多个 Query 头共享同一组 Key 和 Value 头
- MHA(Multi-Head Attention):每个 Q 头有自己独立的 K、V 头。
- MQA(Multi-Query Attention):所有 Q 头共享一组 K、V 头。
- GQA(Grouped-Query Attention):折中方案。将 个Q头分成 组,每组共享一个K头和一个V头。每组包含 个Q头。
公式表达:
其中 是每组内的Q头数量; 表示K/V头数量。
参数量对比(以 为例):
| 方案 | 参数量 | KV Cache 缩减 | 效果 | |
|---|---|---|---|---|
| MHA | 32 | 基准 | 最佳 | |
| GQA-8 | 8 | 4× | 接近 MHA | |
| MQA | 1 | 32× | 略有下降 |
(3)Flash Attention
Flash Attention 不改变注意力的数学定义,而是从IO 感知(IO-Aware) 的角度优化了计算过程。
标准 Attention 的计算流程会产生大量中间矩阵( 的注意力分数矩阵),这些矩阵需要在 GPU 的 HBM(高带宽显存)和 SRAM(片上缓存)之间反复读写,IO 成为瓶颈。
Flash Attention 的核心策略:
- 分块计算(Tiling):将 Q、K、V 分成小块(block),在 SRAM 中完成 的计算,避免将 的完整矩阵写回 HBM。
- 在线 Softmax(Online Softmax):传统 softmax 需要两遍扫描(先求最大值,再求归一化),Flash Attention 通过维护运行时的最大值和分母,实现单遍计算。
- 重计算(Recomputation):前向传播时不保存注意力矩阵,反向传播时重新计算,用计算换内存。
最终效果是:FlashAttention避免显式物化完整的 注意力矩阵,使中间注意力状态的显存占用从二次级别降到近似线性级别;但它并没有改变Attention本身的理论计算复杂度,注意力计算仍然具有随序列长度二次增长的计算项。FlashAttention优化的核心是GPU内存访问与中间结果存储,而不是改变算法的渐进计算复杂度。
2. Position Embedding (位置编码)
基本原理
在不加入位置信息时,Self-Attention对输入序列的排列具有置换等变性(Permutation Equivariance)。也就是说,如果同时打乱输入token的顺序,输出也会按照相同方式重新排列。因此,Self-Attention本身无法仅凭内容区分token的绝对顺序,所以Transformer需要额外注入位置信息。
原始做法(Sinusoidal 绝对位置编码)
原始 Transformer 使用正余弦函数生成固定的位置向量,直接加到 Token Embedding 上:
其中 是 token 在序列中的位置, 是维度索引。不同频率的正余弦波编码了不同尺度的位置信息。
缺点:
- 只编码了绝对位置,对相对距离的感知是隐式的。
- 外推能力差:训练时没见过的长度,推理时效果急剧下降。
现代做法:RoPE(Rotary Position Embedding,旋转位置编码)
RoPE已经被Qwen、LLaMA、GLM等许多主流大模型采用,是现代LLM中非常常见的位置编码方案。
核心思想是,不直接把位置向量加到词向量上,而是将位置信息编码为旋转矩阵,在计算 Attention 的 Q 和 K 内积时,对它们进行旋转。这样做的结果是,Q-K内积中的位置相关项可以写成它们位置差的函数,从而显式引入相对位置信息。
数学推导
设位置为 的 token 的 Query 向量为 ,位置为 的 token 的 Key 向量为 。RoPE 对它们施加旋转:
其中 是位置 对应的旋转矩阵。
对于二维情况,旋转矩阵为:
对于 维向量( 为偶数),RoPE 将向量两两分组,每组施加不同频率的旋转:
其中 ,与原始 Sinusoidal 编码的频率设计一致。
相对位置的实现
旋转后的 Q 和 K 做内积:
由于旋转矩阵满足 ,位置相关的旋转项可以写成相对位置 的形式,这正是RoPE能够显式表达相对位置信息的关键原因。需要注意,Q和K本身仍然由token内容及网络参数决定,因此不能简单说整个注意力分数与绝对位置完全无关。
实现上的简化
实际代码中通常不需要显式构造完整的旋转矩阵。在采用half-split表示的一类实现中,RoPE可以写成逐元素操作:
在采用half-split表示的实现中, 将向量的前后两半交换并对其中一半取反:
参数量:RoPE 不引入任何额外参数。它只依赖位置索引和预设的频率 ,是纯粹的计算操作。
RoPE 的优势:
- 天然编码相对位置,符合语言理解的需求。
- RoPE 可以自然地定义到训练长度之外,但模型在未训练过的超长位置上可能出现明显性能退化,因此实际长上下文模型通常还需要结合位置插值或 RoPE scaling 等方法。此处可看下文的长下文扩展技术部分
- 不引入可学习参数;位置相关的正余弦值通常由位置索引和预设频率计算得到。
- 不需要显式保存一个与序列长度平方相关的位置编码矩阵。
脉络延伸:ALiBi与上下文扩展
ALiBi(Attention with Linear Biases,带线性偏置的注意力) 代表与 RoPE 截然不同的路线:它完全取消位置编码,转而直接在 softmax 之前的注意力分数上叠加一个与查询—键相对距离成正比的负偏置:
其中斜率 为按头固定的常数(不同头取几何序列形式的不同量级),距离越远扣分越多,从而把就近优先的相对位置先验显式写入注意力分数。
上下文扩展技术:
前文提到“RoPE 理论上可以自然地定义到训练长度之外,但模型在未训练过的超长位置上可能出现明显性能退化。”因此,我们需要额外引进长上下文扩展技术来缓解该问题。
该问题的代表技术有:
- 位置插值(Position Interpolation):将推理位置 线性压缩回训练区间,即 ,以少量微调代价复用模型已学过的位置表示
- NTK-aware Scaling:从频谱视角把 RoPE 的底数放大为 ,让低频分量扩展波长、高频分量保持分辨力,从而在不重训(或极少微调)的前提下改善外推
- YaRN 的改进:在 NTK 思路基础上对不同频段采用差异化的插值/外推混合策略,并配合注意力温度缩放,进一步降低扩展到超长上下文所需的微调成本
- 动态 NTK:使缩放系数随当前序列长度自适应变化。短序列退化为原始 RoPE、长序列自动放大底数,在不重新训练的前提下兼顾短文本精度与长文本外推
3. LayerNorm (层归一化)
基本原理
深度网络在训练时,每一层输入的分布会随着前面层参数的更新而不断改变(内部协变量偏移)。LayerNorm通过对特征维度进行标准化,并配合可学习的缩放与偏移参数,使网络训练更加稳定。
标准 LayerNorm 公式:
其中:
- (均值)
- (方差)
- 是可学习的缩放和偏移参数
- 是防止除零的小常数
参数量:每层 个参数( 和 各 个)。以 为例,每层 8192 个参数,几乎可以忽略不计。
现代做法:Pre-Norm + RMSNorm
(1)Post-Norm → Pre-Norm
原始 Transformer 使用 Post-Norm(残差相加之后做归一化):
许多现代大模型采用 Pre-Norm(残差相加之前做归一化):
为什么 Pre-Norm 更好?
第一,出于训练稳定性的考量。在Post-Norm 中,残差路径上的信号被归一化层截断,梯度回传时需要经过归一化层的 Jacobian,深层网络中容易梯度不稳定。Pre-Norm 保留了完整的残差路径( 直接加到输出上),梯度可以无损回传。
第二是可堆叠深度。随着网络深度增加,Pre-Norm通常比原始Post-Norm更容易优化和稳定训练,因此成为深层Transformer和现代LLM中常见的选择;Post-Norm也可以通过初始化、残差缩放等技术训练更深的网络。
那代价是什么呢?代价是Pre-Norm与Post-Norm在优化性质和表示行为上存在不同的trade-off,但不宜简单概括为“表达能力更弱”。在实际大模型中,Pre-Norm的训练稳定性优势通常更受重视。
(2)LayerNorm → RMSNorm
RMSNorm(Root Mean Square Normalization)由Biao Zhang和Rico Sennrich于2019年提出,核心思想是:去掉减去均值的操作,只做除以均方根。
与标准 LayerNorm 对比:
| LayerNorm | RMSNorm | |
|---|---|---|
| 计算均值 | 需要 | 不需要 |
| 计算方差 | 需要 | 用均方根替代 |
| 可学习偏移 | 有 | 没有 |
| 可学习缩放 | 有 | 有 |
| 参数量 | ||
| 计算量 | 较高 | 减少约 30-50% |
为什么去掉均值也可以?
原论文的实验表明,在其测试设置中,重新中心化并不是获得良好效果的必要条件;RMSNorm仅保留缩放操作,也能取得具有竞争力的结果。真正起作用的是缩放操作,其防止某些维度的数值过大或过小。RMSNorm 只保留缩放,去掉了中心化,既简化了计算,又保持了训练稳定性。
参数量:每层 个参数(只有 )。以 为例,每层 4096 个参数。
4. Residual Add (残差连接)
基本原理
借鉴自计算机视觉中的 ResNet,公式极其简单:
它改善了深层网络中的梯度传播。由于存在直接的残差路径,梯度可以绕过子层传播,从而缓解深层网络优化中的梯度消失与训练不稳定问题。
从信息流的角度看,残差连接保证了即使 SubLayer 学到的权重趋近于 0,模型最差也能学到恒等映射(直接把输入 传递过去),保证了模型能力下限。
梯度流分析
设 层网络的输出为:
对 求梯度:
注意前面的 1,这意味着无论网络多深,梯度中存在恒等路径对应的直接项,但完整梯度还包含各个子层的 Jacobian,因此不能简单理解为梯度一定不会消失。
现代做法:DeepNorm
虽然标准残差连接已经足够好,但在训练极深的 Transformer 时,仍然可能出现训练不稳定的问题。微软提出的 DeepNorm 对此做了改进:
其中 和 是与网络深度 相关的缩放因子:
- :放大残差路径上的信号,确保主干信息不被稀释。
- :缩小子层的输出,防止深层网络中子层输出的累积导致数值爆炸。
配合特定的参数初始化策略,DeepNorm 使得训练 1000 层深的 Transformer 成为可能。
参数量:残差连接本身不引入任何参数,它是纯粹的加法操作。
不过理论上DeepNorm确实会有优势,但实际上由于传统的残差连接实现简单,外加社区验证充分,没有必要额外引入新的超参。当今大模型也就难以看到DeepNorm的身影了。所以标题的“现代做法”也仅仅是表示微软对传统残差连接的改进而已。
5. FFN (前馈神经网络)
基本原理
如果说 Attention 负责的是词与词之间的信息交互与路由,那么 FFN 负责的就是单个词内部信息的非线性加工与记忆。
学术界普遍认为,FFN 层充当了 Transformer 的知识记忆库(Key-Value Memory)。模型在预训练阶段学到的世界知识,很大一部分被记录在了 FFN 的权重矩阵中。
原始结构
即:先通过 升维(通常 ),经 ReLU 激活,再通过 降维回 。
参数量(原始):
以 为例:
现代做法:SwiGLU / GeGLU 门控 FFN
(1)门控机制的引入
许多现代大语言模型不再采用传统的ReLU FFN,而是使用SwiGLU、GeGLU等基于 门控(Gating) 的FFN变体。核心思想是让网络自己学习哪些信息应该通过,哪些应该被抑制。
Swish / SiLU 激活函数:
SwiGLU FFN:
其中 表示逐元素乘法。三个权重矩阵的作用:
- :生成门控信号(决定放行多少)
- :生成信息内容(决定放行什么)
- :将结果映射回 维度
GeGLU FFN(另一种常见变体):
其中 , 是标准正态分布的 CDF。
(2)维度调整
由于 SwiGLU 引入了三个权重矩阵(),比原始 FFN 多了一个矩阵。为了保持总参数量不变,通常将 从 缩小到 (再取整到 256 的倍数以对齐硬件):
以 为例:,取整到 256 的倍数为 11008(这是 LLaMA 的选择)。
参数量对比
| 方案 | 权重矩阵数 | 中间维度 | 参数量 |
|---|---|---|---|
| 原始 FFN (ReLU) | 2 () | ||
| SwiGLU | 3 () |
可以看到,通过缩小中间维度,SwiGLU 的参数量与原始 FFN 几乎相同,但表达能力显著增强。
为什么 SwiGLU 更好?
首先是引入了门控机制, 充当了一个软开关,可以动态地放大或抑制 中的不同维度,比固定的 ReLU 截断更灵活。
其次是具有平滑性,SiLU/GELU 是平滑函数,处处可导,不像 ReLU 在 0 点有尖角,有利于优化。
在PaLM等大规模语言模型实验中,SwiGLU等门控FFN相较传统FFN展现出更好的验证集表现,不过具体收益会随模型规模、参数预算和训练设置而变化。
6. DecoderBlock
现代做法:Pre-Norm DecoderBlock(以 LLaMA 为例)
许多现代LLM采用如下的Pre-Norm Decoder Block结构:
具体展开,一个完整的 DecoderBlock 包含两个子层:
子层 1:Masked Self-Attention
子层 2:SwiGLU FFN
完整的数学表达:
数据流示意:
1 | 输入 x: (seq_len, d_model) |
组件总览表
| 组件 | 原始 Transformer (2017) | 现代大模型 | 关键改进 |
|---|---|---|---|
| 注意力 | MHA | GQA / MQA + Flash Attention | KV Cache 显存优化,计算加速 |
| 位置编码 | Sinusoidal(加法,绝对) | RoPE(旋转) | 显式引入相对位置信息;长上下文仍需额外的scaling/插值技术 |
| 归一化 | Post-LayerNorm | Pre-RMSNorm | 常用于提升深层训练稳定性,并减少归一化计算 |
| 残差连接 | 标准 | 标准(超深网络用 DeepNorm) | 基本不变 |
| FFN | 2层 + ReLU | 3层 SwiGLU 门控 | 表达能力增强 |
| 激活函数 | ReLU | SiLU / GELU | 平滑可导,效果更好 |
| 输出头 | 独立 Linear | 视模型而定,可独立或Weight Tying | Weight Tying可减少参数量,但并非现代LLM统一采用 |
估算参数量
以LLaMA-2-7B为例。
参数量完整计算
模型配置:, 层,,(MHA),
| 组件 | 计算 | 每层参数量 |
|---|---|---|
| 16.8M | ||
| 16.8M | ||
| 16.8M | ||
| 16.8M | ||
| 45.1M | ||
| 45.1M | ||
| 45.1M | ||
| RMSNorm × 2 | 0.008M | |
| 每层合计 | ~202.5M | |
| 32 层合计 | ~6.48B | |
| Token Embedding | 131M | |
| Final RMSNorm | ~0 | |
| LM Head(独立权重) | 131M | |
| 模型总计 | ~6.74B ≈ 7B |
计算公式为:
其中 四个矩阵均为 ,即四矩阵参数量之和为
而 FFN部分中, 的参数量之和为
同时单层Decoder Block里有两次RMSNorm,即
设共有 层,那么总共的参数量就是 加上两个嵌入矩阵的参数量
对于采用SwiGLU且将中间维度近似取为 的模型,可以进一步近似为
从表中可以看到
- FFN 占每层参数的 67%(),是模型中参数最多的组件。
- Attention 占每层参数的 33%()。
- RMSNorm 的参数量完全可以忽略。
- 大部分知识存储在 FFN 的权重中。
结语
回顾整篇文章,我们从一个简单的问题出发:为什么 Transformer 能在短短几年内,彻底取代 RNN 和 LSTM,成为 NLP 乃至整个 AI 领域的基石?
答案其实并不复杂。Transformer 的成功,本质上是三个简单的胜利:
- 结构简单:抛弃了循环和递归,只留下注意力和前馈网络。没有花哨的门控,没有复杂的记忆单元,有的只是矩阵乘法和 softmax。
- 范式简单:一个统一的预测下一个 token目标,就能覆盖翻译、摘要、问答、推理、代码生成……几乎所有你能想到的语言任务。不再需要为每个任务设计专门的模型结构。
- 扩展简单:由于天然适配并行计算,Transformer 可以毫无障碍地吃下更多的数据、更多的参数、更多的算力。Scaling Law 告诉我们,只要把模型做大、数据做多、算力堆够,智能就会涌现。
从组件层面看,我们拆解了Attention如何让token进行信息交互,RoPE如何引入相对位置信息,RMSNorm和Pre-Norm如何帮助深层网络稳定训练,SwiGLU如何增强FFN的非线性表达能力,以及残差连接如何改善深层网络中的信息与梯度传播。每一个组件都不复杂,但当它们被组装成 DecoderBlock,再被堆叠 32 层、80 层、128 层时,量变引发了质变,一个以预测下一个token为训练目标的模型,开始展现出复杂的语言理解、推理、代码生成等能力。
这或许是深度学习最迷人也最令人困惑的地方:我们完全理解每一个零件的工作原理,却仍然无法完全解释它们组合在一起后涌现出的智能。
当然,Transformer 不会是终点。我们已经看到了它的局限: 的注意力复杂度限制了超长上下文,自回归生成在Decode阶段具有天然的串行依赖,导致生成阶段难以像训练一样沿序列维度完全并行,纯粹的下一词预测范式在复杂规划和多步推理上仍有短板。Mamba 等状态空间模型、扩散语言模型、混合架构等方向正在被积极探索。但无论未来的架构叫什么名字,Transformer所推动的核心范式——用注意力机制进行信息交互、用大规模预训练获取通用能力,并在许多LLM中通过自回归生成完成语言建模与交互——仍将继续影响下一代模型的设计。
2017 年,八位作者用一篇论文告诉我们:Attention Is All You Need。
几年后的今天,这句话的含义已经远远超出了技术本身。它更像是一个隐喻:在通往通用人工智能的道路上,我们最需要的,或许不是更复杂的结构,而是对注意力,对信息的选择、聚焦与关联的更深刻的理解。
希望这篇文章,能帮你建立起对 Transformer 从宏观到微观的完整认知。如果你读到了这里,感谢你的耐心。
全文完